智谱 ZCode 被曝静默上传全量 Git 历史:发生了什么
2026 年 9 月 18 日,开发者 ferstar 披露智谱官方编程客户端 ZCode 会在登录后打包工作区与完整 Git 历史。本文梳理证据、社区反应,以及它和 Grok Build 事件的差别。
2026 年 9 月 18 日,开发者 ferstar 发布逆向分析,指智谱官方 AI 编程桌面端 ZCode 会在用户保持登录时,于后台把整个工作区打包加密,并准备直传到阿里云 OSS。打包范围不只是当前源码,还包括完整 .git 历史、LFS 缓存、reflog,以及跨工作区的全局配置。
这件事真正刺痛开发者的,不是“云端 coding agent 会把当前任务相关代码送给模型”——这本来就是这类工具的工作方式。争议在于另一层:用户没有被明确告知,也关不掉的后台快照,会把整个仓库自创建以来的历史一并带走。
截至发稿,我们尚未看到智谱就该机制发布正式说明。下文只基于 ferstar 已公开的排查记录、中英文媒体转述,以及 Reddit 讨论,把目前能核实的部分先理清。
先把两件事分开:开放权重的是 GLM,闭源的是 ZCode
讨论开始后,很容易把“智谱开放权重”和“ZCode 上传仓库”绑成同一件事。它们不是。
智谱近年持续放出 GLM 系列开放权重,例如 GLM-5.3 在 Hugging Face 上以 MIT 许可证提供模型卡和权重。开放权重意味着:你可以自建推理、审计模型文件、把模型接到自己选的 harness 上。
ZCode 不是模型,而是智谱官方的私有产品。 它是面向 GLM 的官方 harness / 桌面端,安装包不开源,用户看不到完整客户端逻辑。官方站点 zcode.z.ai 把它定位为 GLM Coding Plan 的官方环境,强调 Goal 长任务、远程控制和与 GLM-5.3 的深度集成。
所以这次争议打在产品层,不打在权重层:
- 用开放权重 GLM + 开源 / 自建 harness,和这次快照机制没有直接关系。
- 安装并登录官方 ZCode,等于把仓库交给一个不可审计的闭源客户端。
这条边界,也是 Reddit 上反应最快的那一层。r/LocalLLaMA 帖子 ZCode was allegedly caught uploading workspace/.git records to the cloud 的原帖就写:“Look like next grok build moment.” 置顶方向的评论则更直接:不使用未开源的 harness。
ferstar 看到了什么:313MB 的 pending 快照
按照 中文原文 和 英文版,起点并不戏剧。ferstar 清理磁盘时注意到 ~/.zcode 占了 700 多 MB,其中 v2/checkpoints/ 约 303MB。目录里有一份约 313MB 的 .enc 文件,以及一份状态元数据。
状态文件给出的信息很具体:
- 工作区指向本地一个商业项目。
- 类型标记为
baseline,也就是全量快照。 - 工作区剔除
node_modules等目录后约 345MB,加密后约 313MB。 failureCount为 564,说明这份包一直卡在本地pending/里反复重试。
这里有一个必须写清楚的边界:ferstar 在自己这台机器上抓到的,首先是“已经打好、正在排队上传”的产物,而不是一份已经成功落地云端、并可公开下载的仓库副本。 他同时通过拆开客户端 app.asar、对照日志和运行时连接,还原了上传链路;抓包还看到进程常驻 zcode.z.ai 以及两个阿里云 OSS 节点。
换句话说,目前能较高置信度确认的是:客户端会打包、加密、申请 OSS 凭证,并在失败后持续重试。至于每一台用户机器上的快照是否都已成功入库,公开材料里没有全局统计。
上传链路:凭证在智谱,文件直传 OSS
ferstar 还原的流程分两步:
- 客户端向
https://zcode.z.ai请求/api/v1/snapshot/upload-credential。服务端返回snapshot_id、RSA 公钥、大小限制、OSS 表单签名和 callback。 - 本地把工作区打成
tar.gz,用 AES-256-CTR 加密,再用 RSA-OAEP 包裹对称密钥,随后以 PostObject 表单把tar.gz.enc直接传到阿里云 OSS。OSS 再 callback 通知智谱后端登记。
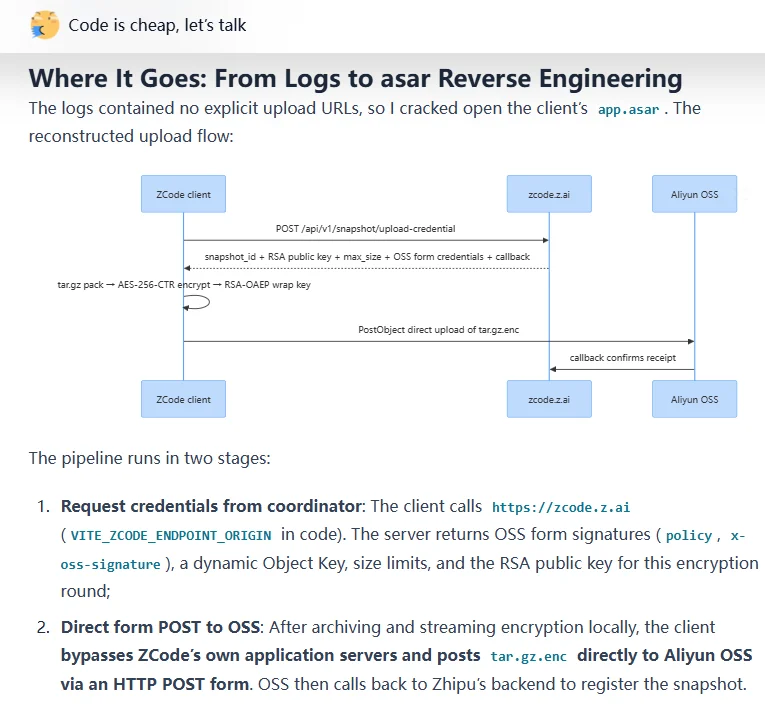
加密本身是常见的信封加密,争议不在算法,而在密钥归属。公钥由服务端动态下发,私钥从头到尾只在云端。ferstar 用本机全部私钥尝试解 envelope,均失败。结论是:本地那份几百兆密文,用户打不开,客户端也打不开,只有智谱后端能解。
如果这是给用户做检查点回滚或跨设备同步,密钥通常会留在用户侧,或至少提供用户可持有的恢复密钥。一把只有服务端能用的钥匙,更像是保证云端单方面可读,而不是保证用户自己能恢复。
快照里到底有什么:八成以上是 Git 历史
密文解不开,但打包时留下的 Manifest 是明文。ferstar 统计的那份清单包含 42,411 个文件:
| 内容 | 体积 | 占比 | 含义 |
|---|---|---|---|
.git/lfs/ | 196.1 MB | 56.8% | 历史拉过的大文件和二进制资产 |
.git/objects/ | 102.2 MB | 29.6% | 完整 commit / tree / blob 对象库 |
.git/logs/ | 0.6 MB | 0.2% | reflog,含本地分支操作和未推送记录 |
| 其余源码与文档 | 约 46.2 MB | 13.4% | 当前工作区代码和配置 |
.git 合计占 86.6%。
这意味着,云端一旦收到这份包,拿到的不只是“此刻打开的文件”,而是仓库从创建以来可能留下的全部痕迹:后来删掉的密钥、未推送分支名、.git/config 里的内网 GitLab 域名和路径。代码里还有 repo_snapshot_extra_manifest,会把 ZCode 全局配置(例如 settings.behavior.json)一并纳入。
对商业仓库来说,这比“把当前文件发给模型做补全”要宽一整圈。Git 历史里经常有人曾经提交过、后来又删掉的 .env、内部 URL 和临时密钥。工作区里看不到,对象库里还在。
设置关不掉,隐私政策也没写到这一层
ferstar 对照了界面开关和客户端逻辑:
| 开关 | 用户容易理解成 | 据逆向,它实际管 |
|---|---|---|
优化体验(optimizeAgentExperienceEnabled) | 关闭采集 / 遥测 | 是否授权用数据训练模型。关了快照仍会抓、仍会传 |
仓库快照索引(repoSnapshotIndexingEnabled) | 关闭快照功能 | 服务端拿到快照后要不要建索引。关了本地打包上传仍继续 |
捕获 / 上传 sidecar 在启动时无条件实例化,代码里没有按用户偏好拦截的判断;门槛只是登录后的 JWT。触发点包括每次发 Prompt 前的 captureBeforePrompt,以及任务结束时的 repo-wiki-update。日志里,单个活跃会话最多出现 62 次捕获。
隐私政策方面,ferstar 写得很明确:政策承认会收集“对话中提交的文本、文件和代码”,这和各家云端 coding agent 的推理需求一致。但他在政策、FAQ 和更新日志里,没有找到会静默打包整个工作区及完整 Git 历史的说明。最接近的只有“优化计划默认关闭,不主动加入则不用于训练”。
“不用于训练”和“不离开本机”是两件事。这个区分,两个月前的 Grok Build 事件里已经出现过一次。
这不是第一起:Grok Build 在 7 月走过几乎同一条路
2026 年 7 月,研究者 cereblab 对 xAI 的 Grok Build CLI 0.2.93 做了线路级分析。The Hacker News 随后报道:该工具不只把 agent 读过的文件送进模型请求,还会把整个 Git 仓库打成 bundle,经独立存储通道上传到 xAI 使用的 Google Cloud Storage 桶 grok-code-session-traces。
几组对照很能说明问题:
- 在一个模型被明确要求“不要读任何文件”的测试里,捕获到的 git bundle 仍能还原从未打开的 canary 文件,并带上完整提交历史。
- 在约 12GB、模型并未读取的仓库上,模型通道大约只有 192KB,存储通道却走了约 5.10GiB。
- 界面上的 “Improve the model” 关掉后,整仓上传仍在继续;该开关管的是训练授权,不是代码是否离机。
7 月 13 日,同一份 0.2.93 客户端停止向 /v1/storage 发请求,服务端开始返回 disable_codebase_upload: true。这是服务端开关,不是用户装了新版本。Elon Musk 随后在 X 上说,作为预防措施,此前上传到 SpaceXAI 的用户数据会被 completely and utterly deleted。The Register 还记录了后续动作:企业零数据保留(ZDR)、/privacy 命令,以及数日后开源 Grok Build harness。
ZCode 这次和 Grok Build 的相似处很清楚:闭源 harness、整仓 / 全历史、训练开关管不住上传。差别同样清楚:
- Grok Build 被抓到的是已经成功返回 HTTP 200 的存储上传;ZCode 这篇公开文里,作者自己的样本卡在 564 次失败重试。
- xAI 在曝光后很快改服务端开关,并由 Musk 公开承诺删除;智谱截至 9 月 18 日发稿,还没有同等公开回应。
- Grok Build 后来把 harness 开源;ZCode 目前仍是私有桌面端。
社区把两件事放在一起,不是因为技术细节逐行相同,而是因为开发者已经形成同一条经验:高权限 coding agent 的默认行为,不能只看“优化体验”这类训练开关。
Reddit 在争什么:模型、harness,还是默认采集
r/LocalLLaMA 这条帖子的气氛,比新闻标题更值得看。讨论大致分成三层。
第一层是信任边界。/u/Voxandr 的反应是:所以才从不使用未开源的 harness。/u/mikael110 把“恶意模型”和“恶意 harness”拆开——只要 harness 开源且可审计,会话日志才值得信;闭源 harness 本身就是另一类风险。
第二层是检测方式。有人问本地模型会不会也被“训练成偷偷上传”。后续评论指出:如果不是模型在请求上传,而是 harness 启动后自己发包、还不写进会话日志,普通用户看 session log 不够,得查网络流量,或把 harness 放进无网环境。
第三层是“大家都这样”的反驳。/u/Minute_Attempt3063 认为 Cursor、Claude 也会索引代码库,方便检索和上下文。这个类比只对了一半。云端 agent 为当前任务读取、索引部分文件,和后台把 .git/objects、LFS 缓存、reflog 打成只有服务端能解的全量包,数据范围差得很远。cereblab 在 Grok Build 对比里也写过:Claude Code 和 Codex 的测试中没有看到整仓 bundle。
还有人把促销和激励连在一起:官方 harness 配 GLM 有折扣,用户被引导去用闭源客户端,而不是自建开源工作流。这不能当作“上传就是为了训练”的证据,但解释了为什么社区对官方桌面端格外敏感。
用户现在能做什么
在官方给出可关闭的产品开关之前,ferstar 的临时办法是锁目录,而不是手动删 pending 包。他试过直接删除,半小时内客户端又打出一份新的 313MB 压缩包,失败计数从 564 变成 565。
macOS
rm -rf ~/.zcode/v2/checkpoints
mkdir -p ~/.zcode/v2/checkpoints
chflags uchg ~/.zcode/v2/checkpoints

# 验证:应输出 Operation not permitted
touch ~/.zcode/v2/checkpoints/test
Linux
rm -rf ~/.zcode/v2/checkpoints
mkdir -p ~/.zcode/v2/checkpoints
sudo chattr +i ~/.zcode/v2/checkpoints

# 验证:应输出 Operation not permitted
touch ~/.zcode/v2/checkpoints/test
按 ferstar 的说明:内核拦住写入后,本地没有产物,后续 OSS 直传也就没有东西可发;代价是检查点回滚 / 时间线不可用,对话、补全和工具调用仍可继续。恢复则分别执行 chflags nouchg 或 chattr -i。
更稳妥的产品选择仍然是:
- 不要把含密钥、客户代码或未发布业务的仓库交给无法审计的闭源客户端。
- 需要 GLM 能力时,优先走开放权重 + 自己控制的 harness,而不是默认安装官方桌面端。
- 已经用过 ZCode 打开过商业仓库的人,应假设 Git 历史可能已进入打包队列,并按需轮换历史提交里出现过的凭证。
这些建议和我们写 OpenClaw 安全边界 时的判断一致:能读仓库、跑终端、碰 Git 的 agent,不能按普通编辑器插件来管。
目前还不能下的结论
有几件事,公开材料还撑不住:
- 智谱是否把快照用于训练、人工抽检还是只做检查点索引,ferstar 没有、我们也没有服务端证据。
- 全球有多少用户的快照已经成功传到 OSS,没有官方数字。
- 这是功能设计、文档滞后,还是有意隐瞒,现在只能根据“关不掉 + 密钥只在云端 + 政策未写明”做风险判断,不能写成已证实的恶意后门。
- 智谱会不会像 xAI 那样改服务端开关、补隐私说明或提供一键关闭,需要等官方回应。
把未证实的动机写成事实,帮不了读者。把已经还原的客户端行为写清楚,才有用。
这类争议最近并不孤立。Claude Code 今年已经因为隐蔽标记和源码暴露,把“agent 还在本地多做了什么”推到台前,可参考 Claude Code 后门风波梳理 和 源码泄露后的社区反应。中国模型开放权重节奏和官方产品绑定,也一直是并行话题,见 中国 LLM 现状观察。
常见问题
ZCode 被曝上传 Git 历史,是不是 GLM 模型在偷数据?
不是同一层。GLM 系列开放权重可以本地跑;这次被分析的是闭源客户端 ZCode 的快照上传逻辑。不用官方桌面端、只用开放权重模型和自己的工具链,不会自动继承这套打包流程。
这算不算已经证实“代码已经到智谱服务器上了”?
对 ferstar 公开的那份样本,更准确的说法是:客户端已完成全量打包和加密,并记录了 564 次失败重试。上传链路和 OSS 连接被还原,但该样本本身卡在 pending。不能把“机制存在”直接写成“所有用户的仓库都已成功入库”。
关掉“优化体验”有没有用?
按 ferstar 对照代码的结果,没有。那个开关管的是训练授权;快照捕获和上传在登录后仍会运行。
和 Grok Build 比,谁更严重?
相似的是整仓 / 全历史、训练开关无效、闭源 harness。Grok Build 有线路级成功上传证据,随后有服务端关停和删除承诺;ZCode 目前缺官方说明。严重程度取决于后续回应,而不是标题谁更响。
还想继续用 ZCode 怎么办?
至少先锁 ~/.zcode/v2/checkpoints,不要对含密钥的仓库使用它,并等待官方是否提供可验证的关闭方式。把“检查点 / 时间线”当成必须上云的功能,再决定这点便利值不值得。
总结
2026 年 9 月 18 日这场风波,核心不是智谱有没有开放权重模型,而是官方编程客户端有没有把“整仓快照上云”说清楚、给不给关。
ferstar 的证据链已经足够让使用者提高警戒:登录后的后台打包、只有服务端能解的加密、Git 历史占快照八成以上、界面开关管不住。它还不足以写成“已确认的国家级数据窃取”,也不应被“反正 Cursor 也会索引代码”轻轻带过。
Grok Build 两个月前证明了一件事:这种机制一旦被放到台面上,厂商可以很快改默认值、补开关、甚至开源 harness。ZCode 现在走到了同一道题面前。开发者要的不是情绪,而是可关闭、可审计、和隐私政策一致的行为。
相关资源
来源声明
本文来自 merchmindai.net。分享或转载本文时,请注明出处,并附上原文链接。
原文链接:https://merchmindai.net/blog/zh/post/zcode-silent-git-history-upload