Claude Fable 5.2 発表、性能向上の先にユーザーが注目すること
Claude Fable 5.2とMythos 5.2が発表され、性能向上とAPI単価の引き下げが示されました。Hacker NewsやRedditでのコスト、使用感、安全制限に関する議論を紹介します。
Anthropicは2026年11月9日、Claude Fable 5.2とClaude Mythos 5.2を発表しました。同社によると、新モデルはコーディング、推論、視覚認識などの能力が向上し、APIのトークン単価も前世代より引き下げられています。
Hacker NewsやRedditでは、ユーザーの関心はベンチマークのスコアから実際の使い勝手へと移りました。タスクを完了するまでの総費用を気にする人もいれば、安全制限やサブスクリプションの使用上限を話題にする人もいます。新モデルの発表を機に、Opus 5.5の性能に対する不満を改めて口にするユーザーもいました。
Fable 5.2とMythos 5.2:性能と速度が向上、単価は引き下げ
Anthropicの公式発表によると、Fable 5.2とMythos 5.2は、長期にわたるソフトウェアプロジェクト、科学研究、複数のエージェントによる協調作業など、複雑で自由度の高い技術的なタスクを対象としています。同社は、両モデルのコーディング、推論、視覚認識が改善したとしています。
Anthropicによると、FableとMythosは同じ基盤モデルを使用していますが、提供方法が異なります。Fableにはサイバーセキュリティと生物学の分野でより厳格な安全対策が施され、より幅広いユーザーに提供されます。関連分野の研究に取り組む組織は、認証を申請することでMythosへのアクセスを得られます。
標準のAPI料金も変更されました。
| モデル | 入力100万トークンあたり | 出力100万トークンあたり |
|---|---|---|
| Fable 5.1 | 10ドル | 50ドル |
| Fable 5.2 | 8ドル | 40ドル |
Fable 5.2の入力・出力単価は、いずれも前世代より20%低くなっています。またAnthropicは、新モデルの出力速度が最大30%向上したとしています。オプションのFast modeではトークン生成速度が標準モードの最大2.5倍になる一方、入力・出力単価も2倍になります。
Anthropicは、ほとんどのコーディングや知的作業ではまずOpus 5.5を使い、より複雑なタスクに直面した際にFableやMythosを検討するよう勧めています。
IPOが近づくAnthropic、成長とコストに注目
新モデルの発表時、Anthropicは上場準備を進めていました。TechCrunchがThe Wall Street Journalを引用して報じたところによると、同社はIPOを引き続き進める計画である一方、一部の機関投資家は従来の約1.5兆ドルという期待を下回る企業価値を議論していました。上場時期と最終的な評価額は、いずれも不透明なままです。
また、Reutersの報道によると、AnthropicはIPOの詳細を含む書類を銀行関係者に送った後、価格に関する情報は不正確だと説明し、書類を更新すると伝えました。そのため、最初に伝わった価格情報を最終的なものと見なすことはできません。
上場を控え、投資家がAnthropicの成長とコストを注視する一方、モデルの発表後にはユーザーもClaudeの利用料金を改めて見直し始めています。
Hacker News:トークン単価が下がっても、タスクの費用が下がるとは限らない
Artificial Analysisの評価結果を取り上げたHacker Newsのスレッドでは、モデルの順位よりもタスクの完了にかかる費用に注目するユーザーがいました。
あるユーザーは評価サイトのデータをもとに、比較された設定ではFable 5.2がタスクあたりに使用する出力トークン数は5.1より大幅に多く、単価が下がってもタスクの総費用は上がりうると指摘しました。一方、最高の推論強度だけに注目するのは公平ではないという意見もあります。effortを低く設定すれば、その評価における性能とコストのバランスも変わるためです。
単価が下がったとしても、最終的な請求額はモデルが使ったトークン数や、結果によって手戻りを減らせるかどうかにも左右されます。推論強度の設定も、コストと性能の両方に影響します。
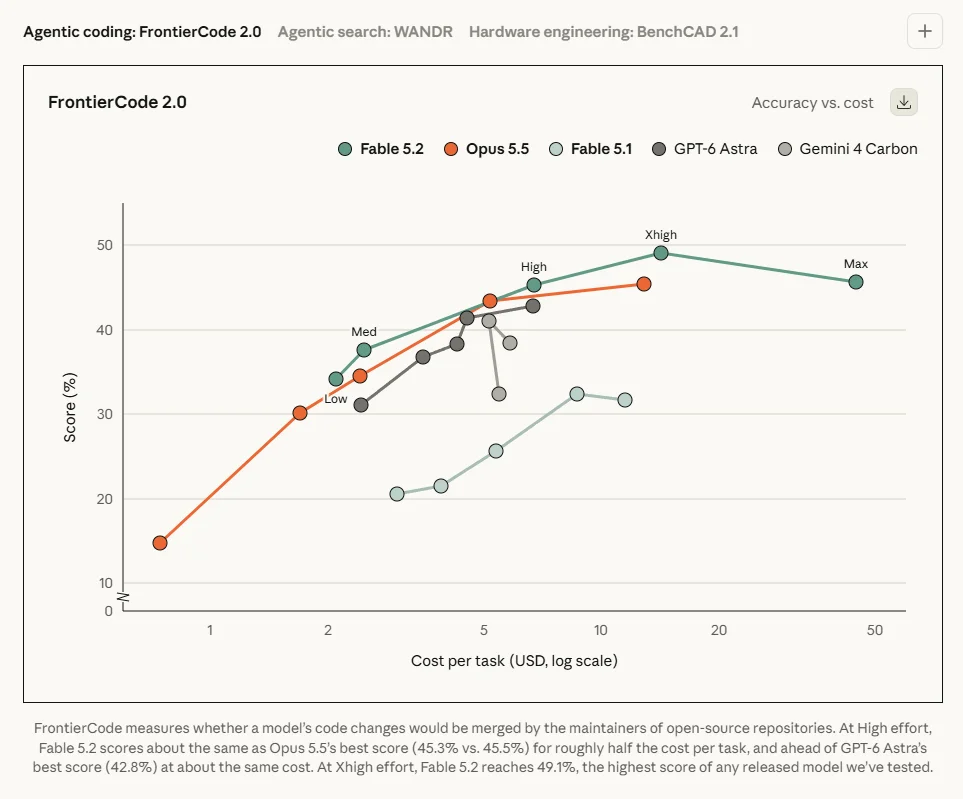
Anthropicは発表の中で一例を挙げています。同社による初期のFrontierCode 2.0テストでは、High effortのFable 5.2が、Max effortのOpus 5.5とほぼ同じスコアを、タスクあたり約半分の費用で達成したといいます。これは同社が特定のテストで得た結果であり、実際の作業での性能はタスクや設定によって異なります。
Reddit:新モデルの発表で、旧モデルの性能も話題に
Redditのr/ClaudeCodeでの議論では、評価の高いコメントの中に、Fable 5.2ではなく最近のOpus 5.5の性能に対する失望を語るものがありました。あるユーザーは「そろそろOpus 5.5を返してもらえますか?」と投稿。別のユーザーは、Claudeが弱体化されたという声が上がると、新モデルの発表が近いのが常だと冗談交じりに書いています。
こうした見方に同意しないユーザーもいます。主にコードレビューにClaudeを使っているあるユーザーは、いわれているような能力低下を普段は感じていないと述べました。また、Opus 5.5を3D関連の作業に使っている別のユーザーも、その性能に今なお満足しており、以前からあった欠点に徐々に気づいただけの人もいるのではないかと推測しています。
コメントには、Anthropicが新モデルのために計算資源を再配分したのではないかという推測もありましたが、根拠は示されていません。モデルの性能にはタスク、コンテキスト、設定などさまざまな要因が影響します。ユーザーの主観的な感覚だけでは、Anthropicが新モデルの発表に合わせて旧モデルを意図的に弱体化したとはいえません。
実際の使用感:コード修正からゲーム制作まで
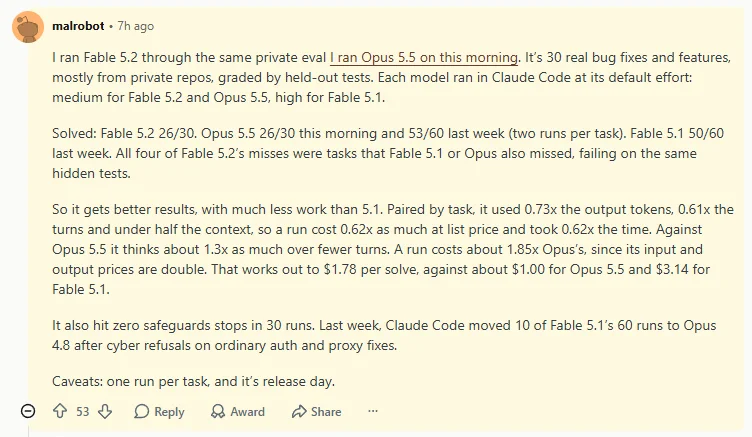
Redditのスレッドでは、あるユーザーが実際のバグ修正と機能開発のタスク30件を使った個人テストを共有しました。本人によると、タスクの大半は非公開リポジトリから集めたもので、評価にはモデルに事前に見せていないテストを使用しています。Fable 5.2とOpus 5.5をそれぞれMedium effortで1回ずつ実行したところ、どちらも30件中26件を解決しました。
このユーザーは、タスクごとに比較すると、Fable 5.2は以前High effortでテストしたFable 5.1よりも、出力トークン数、実行時間、定価で計算した1回あたりの実行費用がいずれも少なかったと報告しています。ただし、このテストでの成功1件あたりの費用は、Fable 5.2が約1.78ドルだったのに対し、Opus 5.5は約1ドルでした。テスト実施者は、発表当日のテストであり、各タスクの実行は1回のみで、モデルごとにeffort設定も異なると注意を添えています。
別のHacker Newsの議論では、あるテスト実施者がモデルを使っていくつかの小さなゲームを制作しました。このユーザーは、新モデルが作ったゲームの仕組みにはより深みがあると感じています。例えば、湖によって分断されたマップの領域をプレイヤーが探索できるよう、モデルは飛行船を追加しました。
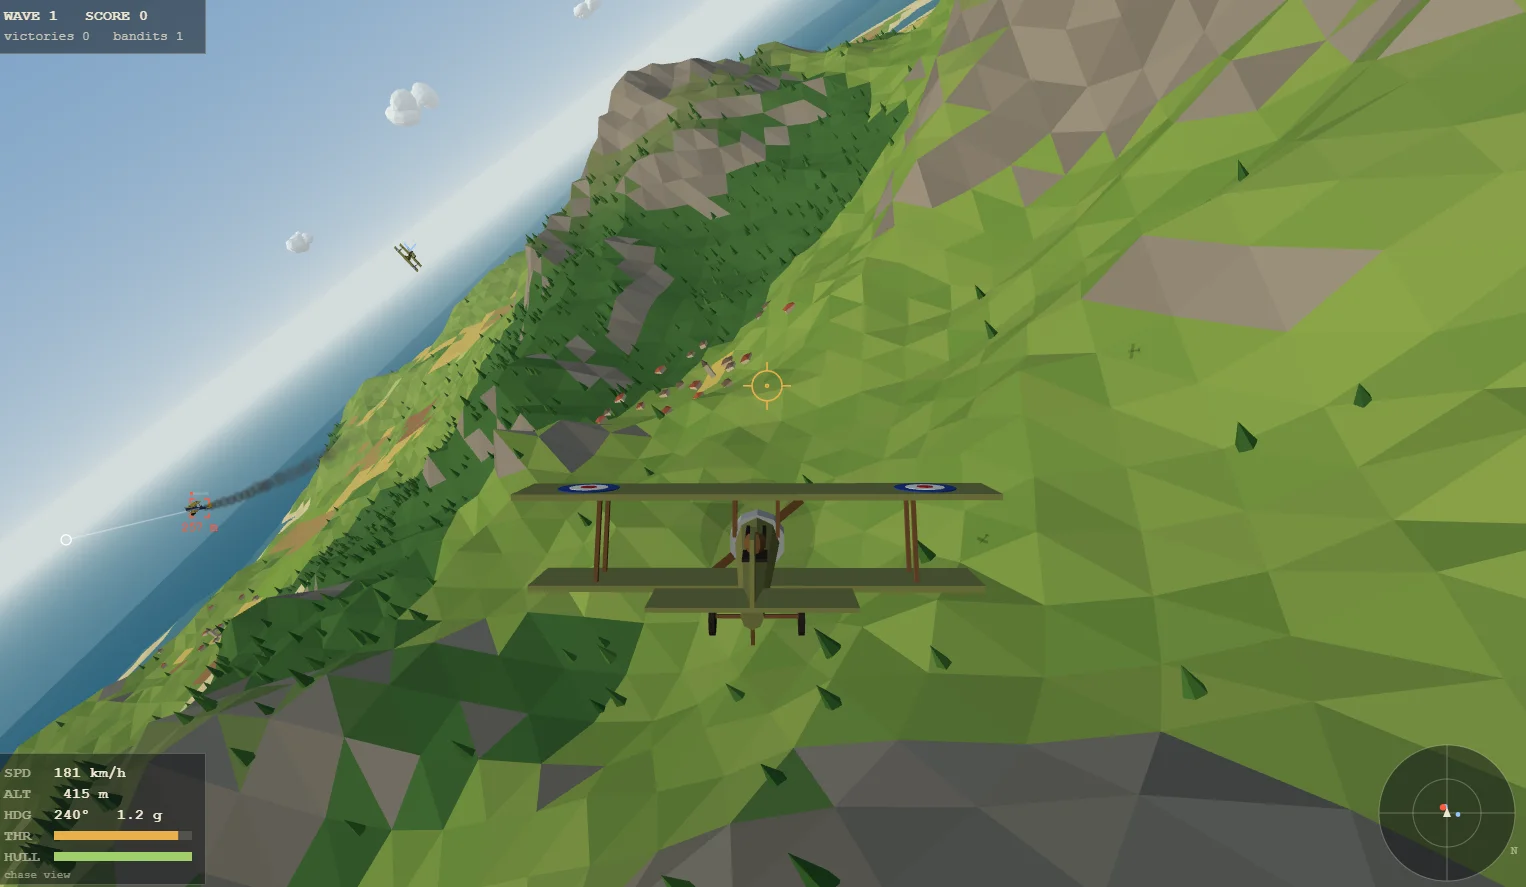
一方で、このユーザーはゲームのグラフィックに目立った改善はなく、一部の見た目はむしろ悪くなったとも指摘しています。同じ議論では、Opus 5.5と比べて大きな進歩を感じられず、Fableの使用枠の消費も速いと感じたユーザーもいました。
こうした初期の使用感からは、モデルの異なる側面が見えてきます。タスクの計画やゲームのロジックが進歩していても、出力された画面が同じように満足のいくものとは限りません。
安全制限:モデルの能力と実際の使いやすさの差
FableとMythosへのアクセス方法の違いも、ユーザーの選択に影響します。Anthropicは発表の中で、Fableの安全対策はサイバーセキュリティ関連のタスクの大半をブロックすると明記しています。関連するニーズを持つ組織は、Cyber Verification Programに申請し、Mythosを利用できます。
正当なセキュリティ業務に携わるユーザーにとって、こうした安全対策は日々の作業に影響する可能性があります。あるRedditユーザーは、サイバーセキュリティの制限に関する公式の説明を引用して不満を表明しました。また、別のユーザーは、CPUのRFサイドチャネル攻撃の理論について尋ねたところ、Opusに切り替えられたと述べています。
反応は一様ではありません。前述の30件のタスクを試したユーザーは、Fable 5.2のテストでは安全対策による中断がなかった一方、以前のFable 5.1では一般的な認証やプロキシの修正タスクの一部でモデルの切り替えが発生したと報告しています。これらの報告は対象タスクが異なるため、全体のブロック率や誤検知率を判断することはできません。
ベンチマークから実際の仕事へ
Fable 5.2の発表後、ユーザーはコード修正やゲーム制作に試用し始めており、Opus 5.5とのコスト差を検討する人もいます。サブスクリプションのユーザーにとってはモデルの使用枠やリセットのルールも日々の利用に影響します。APIユーザーの場合は、トークン単価だけでなく、タスク完了までの総費用にも目を向ける必要があります。
現時点の議論の多くは、発表後の初期的な使用感に基づいています。Fable 5.2が長期的な作業でどのように機能するのか、また能力の向上がそれに伴うコストに見合うのかは、今後さらに実際の利用や独立したテストを通じて検証される必要があります。
参考資料
出典について
この記事は merchmindai.net に掲載された内容です。共有または転載する場合は、出典と元記事のリンクを明記してください。
元記事リンク:https://merchmindai.net/blog/ja/post/claude-fable-5-2-community-reactions