Claude Fable 5.2 发布:性能提升之后,用户更关心什么?
Claude Fable 5.2 和 Mythos 5.2 发布,模型能力提升、API 单价下降。Hacker News 和 Reddit 用户讨论了任务成本、实际体验与安全限制。
Anthropic 于 2026 年 11 月 9 日发布了 Claude Fable 5.2 和 Claude Mythos 5.2。按照官方介绍,新模型在编程、推理和视觉等方面有所提升,API 单价也低于上一代。
在 Hacker News 和 Reddit 上,用户的注意力很快从跑分转向了实际使用。有些人关心完成任务的总费用,有些人讨论安全限制和订阅额度,也有人趁着新模型发布,继续抱怨 Opus 5.5 的表现。
Fable 5.2 和 Mythos 5.2 发布:更强、更快,也降低了单价
根据 Anthropic 官方公告,Fable 5.2 和 Mythos 5.2 面向复杂、开放式的技术任务,例如长期软件项目、科学研究和智能体协作。官方表示,两者在编程、推理和视觉等方面均有所改进。
Anthropic 称,Fable 和 Mythos 使用相同的底层模型,但开放方式不同:Fable 加入了较严格的网络安全和生物安全防护,面向更广泛的用户;从事相关研究的组织可以申请验证,以获得 Mythos 的访问权限。
标准 API 价格也发生了变化:
| 模型 | 每百万输入 token | 每百万输出 token |
|---|---|---|
| Fable 5.1 | 10 美元 | 50 美元 |
| Fable 5.2 | 8 美元 | 40 美元 |
Fable 5.2 的输入和输出单价都比上一代降低了 20%。Anthropic 还表示,新模型的输出速度最高提升 30%;可选的 Fast mode 最高可将 token 生成速度提升至标准模式的 2.5 倍,但输入和输出单价也随之翻倍。
Anthropic 建议多数编码和知识工作先从 Opus 5.5 开始,遇到更复杂的任务时再考虑 Fable 或 Mythos。
IPO 临近,Anthropic 面临增长与成本的双重关注
新模型发布时,Anthropic 正在推进上市准备。TechCrunch 援引《华尔街日报》的报道称,公司计划继续推动 IPO,而部分机构投资者讨论的估值低于此前约 1.5 万亿美元的预期。上市时间与最终估值仍有不确定性。
与此同时,路透社报道,Anthropic 曾向银行发送包含 IPO 发行细节的文件,随后表示其中的定价信息不准确,并称将更新文件。因此,最初流出的定价信息不应被视为最终结果。
上市前夕,投资者关注 Anthropic 的增长和成本;而在模型发布后,用户也开始重新计算使用 Claude 的账单。
Hacker News:token 更便宜,不代表任务更便宜
在一则讨论 Artificial Analysis 评测结果的 Hacker News 帖子中,一些用户首先注意到的不是模型排名,而是完成任务的费用。
一位用户根据评测平台展示的数据指出,在所比较的配置下,Fable 5.2 每个任务使用的输出 token 明显多于 5.1,因此即使单价下降,任务总成本仍可能上升。另一种看法则认为,只盯着最高推理强度并不公平:选择较低的 effort 设置后,模型在该评测中的表现和成本组合会发生变化。
同样是单价下降,最终账单仍取决于模型用了多少 token,以及结果是否减少了返工。不同的推理强度也会改变成本和表现。
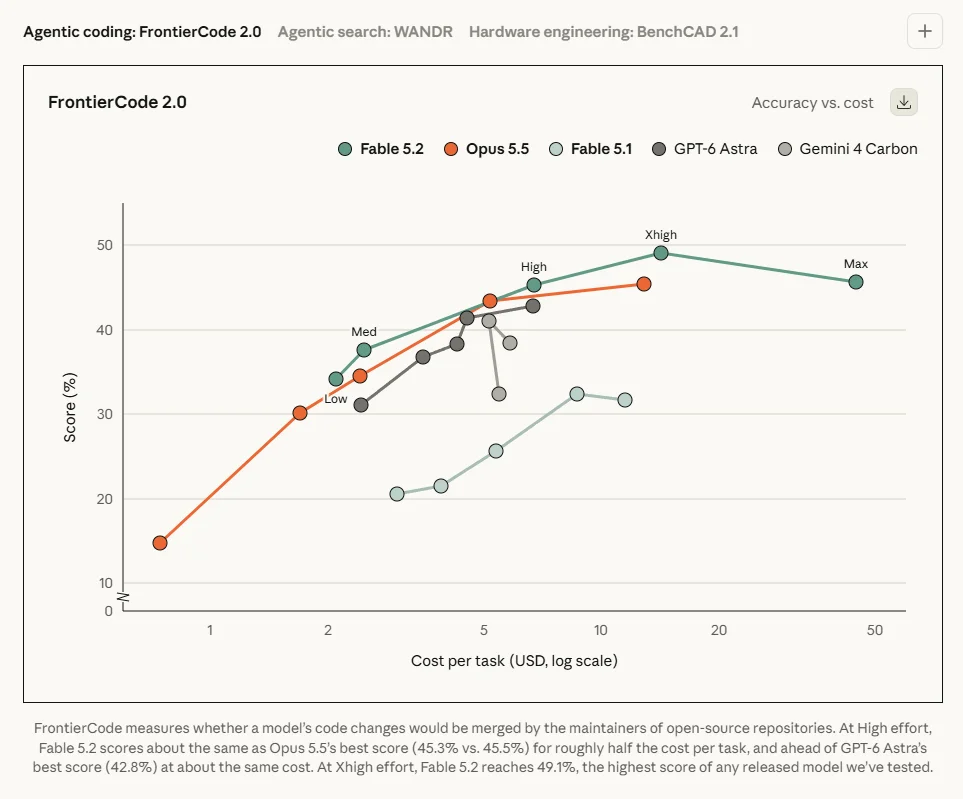
Anthropic 在公告中提供了一个例子:在其早期 FrontierCode 2.0 测试中,Fable 5.2 的 High 设置以大约一半的每任务成本,取得了与 Opus 5.5 Max 大致相当的成绩。这是官方在特定测试中的结果,实际工作中的表现仍取决于任务和使用设置。
Reddit:新模型发布,旧模型的表现也引发讨论
在 Reddit r/ClaudeCode 的讨论中,一些高分评论谈论的不是 Fable 5.2,而是对 Opus 5.5 近期表现的失望。一位用户写道:“现在可以把 Opus 5.5 还给我们了吗?”另一位用户则调侃,每当有人抱怨 Claude 被削弱,就意味着新模型快发布了。
也有用户并不认同这一判断。一位主要用 Claude 审查代码的用户表示,自己通常没有感受到所谓的能力下降;另一位使用 Opus 5.5 处理 3D 任务的用户也表示,依然对它的表现感到满意,并猜测部分人可能只是逐渐注意到了原有缺陷。
评论中有人推测 Anthropic 为新模型重新分配了计算资源,但并未提供证据。模型表现受任务、上下文和使用设置等多种因素影响,用户的主观感受不能证明 Anthropic 为发布新模型而主动削弱旧模型。
实际使用体验:从代码修复到游戏制作
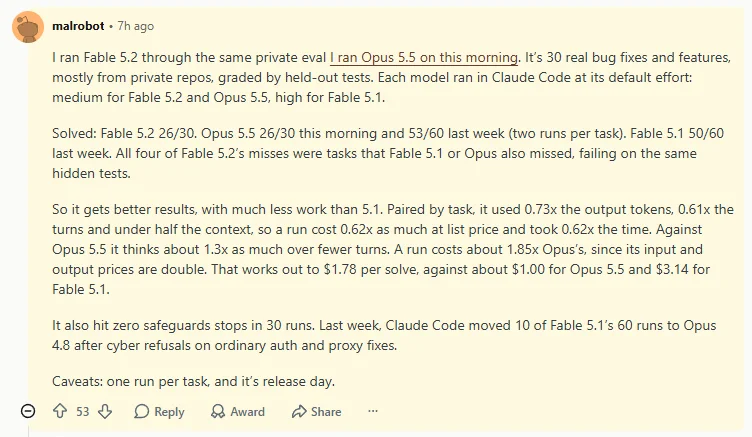
在 Reddit 帖子中,一位用户分享了自己针对 30 个真实 bug 修复和功能开发任务的个人测试。据其描述,任务主要来自私有代码仓库,并通过预留测试评判结果。Fable 5.2 和 Opus 5.5 均以 Medium effort 各运行一次,都完成了其中 26 项。
这位用户还报告,按任务配对比较,Fable 5.2 相比此前以 High effort 测试的 Fable 5.1,输出 token 用量、运行时间和按标价计算的单次运行费用均有所下降。但在这组测试中,Fable 5.2 平均每次成功解决任务的费用约为 1.78 美元,Opus 5.5 约为 1 美元。测试者提醒,这是发布当天的测试,每项任务只运行了一次,且不同版本使用的 effort 设置并不相同。
在另一则 Hacker News 讨论中,一位测试者用模型制作几款小型游戏。他认为,新模型生成的游戏在机制设计上更有深度:例如,为了让玩家探索被湖泊阻隔的地图区域,模型加入了飞行单位。
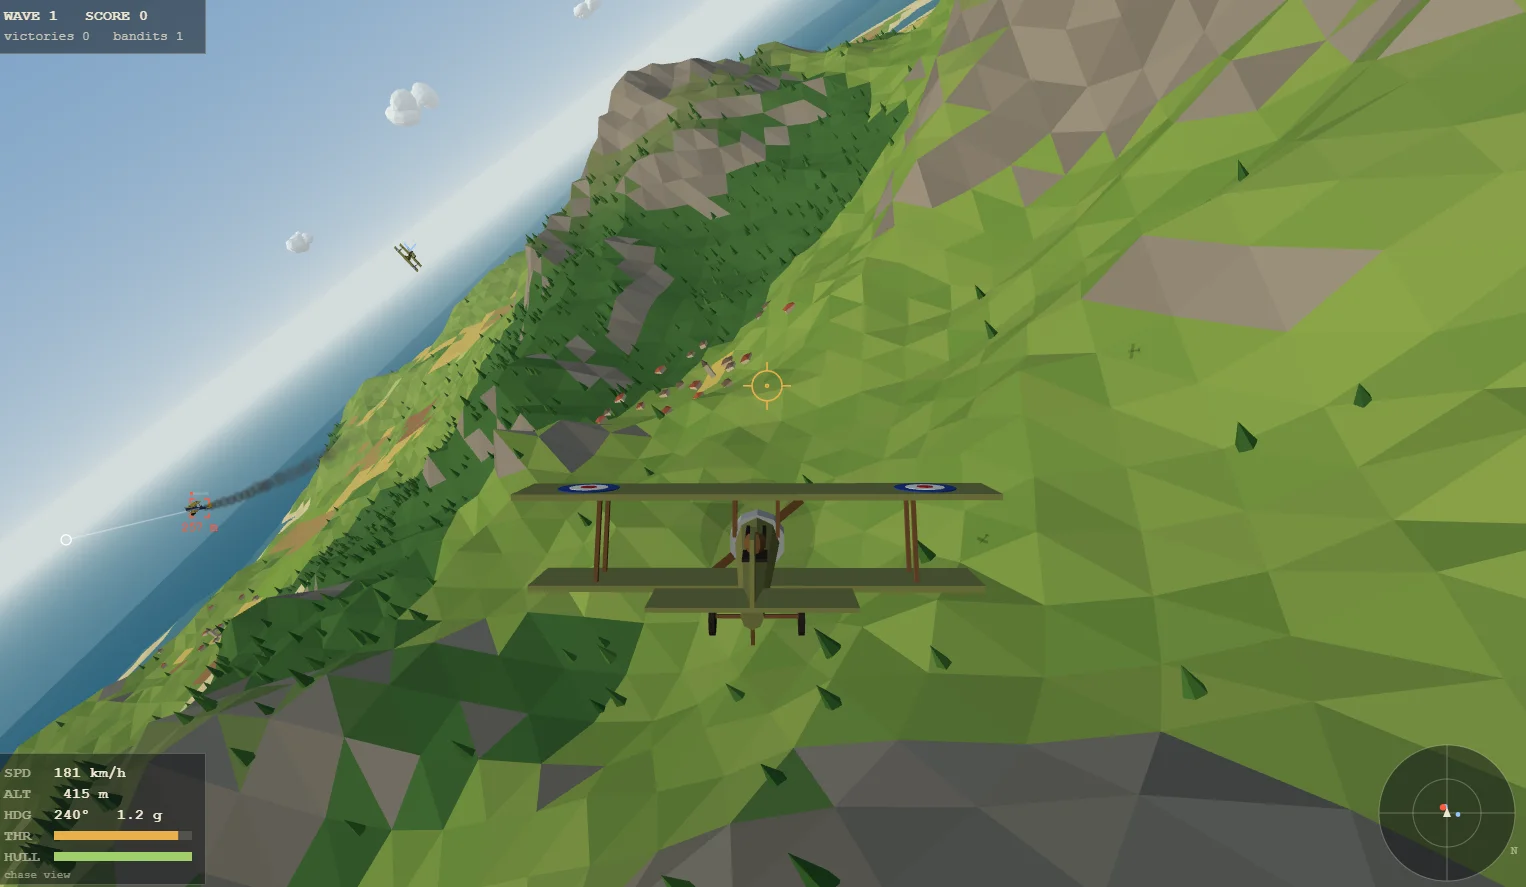
但这位用户也指出,游戏画面并没有明显改善,部分视觉效果甚至更差。另一位用户在同一讨论中表示,自己没有感受到相对于 Opus 5.5 的显著突破,同时觉得 Fable 的使用额度消耗较快。
这些早期体验呈现出了不同侧面:模型可能在任务规划和游戏逻辑上有所进步,但输出的画面未必同样令人满意。
安全限制:模型能力与实际可用性之间的差距
Fable 和 Mythos 的访问差异,是另一个影响用户选择的因素。Anthropic 在发布公告中明确指出,Fable 的安全防护会阻止多数网络安全相关任务;有相关需求的组织可以申请网络安全验证计划,使用 Mythos。
对于从事正当安全工作的用户,这些防护措施可能影响日常工作。一位 Reddit 用户引用官方关于网络安全限制的说明,表达了不满;另有用户表示,自己询问 CPU 射频侧信道攻击的理论时被切换到了 Opus。
反馈并非完全一致:前述 30 项任务的测试者报告,Fable 5.2 的测试中没有遇到安全防护中止,而此前 Fable 5.1 在部分普通认证和代理修复任务中触发过切换。这些用户报告涉及不同任务,无法据此判断整体拦截率或误拦截率。
从跑分到实际工作
Fable 5.2 发布后,用户已经开始尝试用它修复代码、制作游戏,也有人在衡量它和 Opus 5.5 的成本差距。对订阅用户来说,模型额度和重置规则同样影响日常使用;API 用户则需要关注完成任务的总费用,而不只是 token 单价。
目前这些讨论大多来自发布后的初步体验。Fable 5.2 在长期工作中的表现,以及更高的能力能否抵消相应成本,还需要更多实际使用和独立测试来检验。
参考资料
来源声明
本文来自 merchmindai.net。分享或转载本文时,请注明出处,并附上原文链接。
原文链接:https://merchmindai.net/blog/zh/post/claude-fable-5-2-community-reactions